
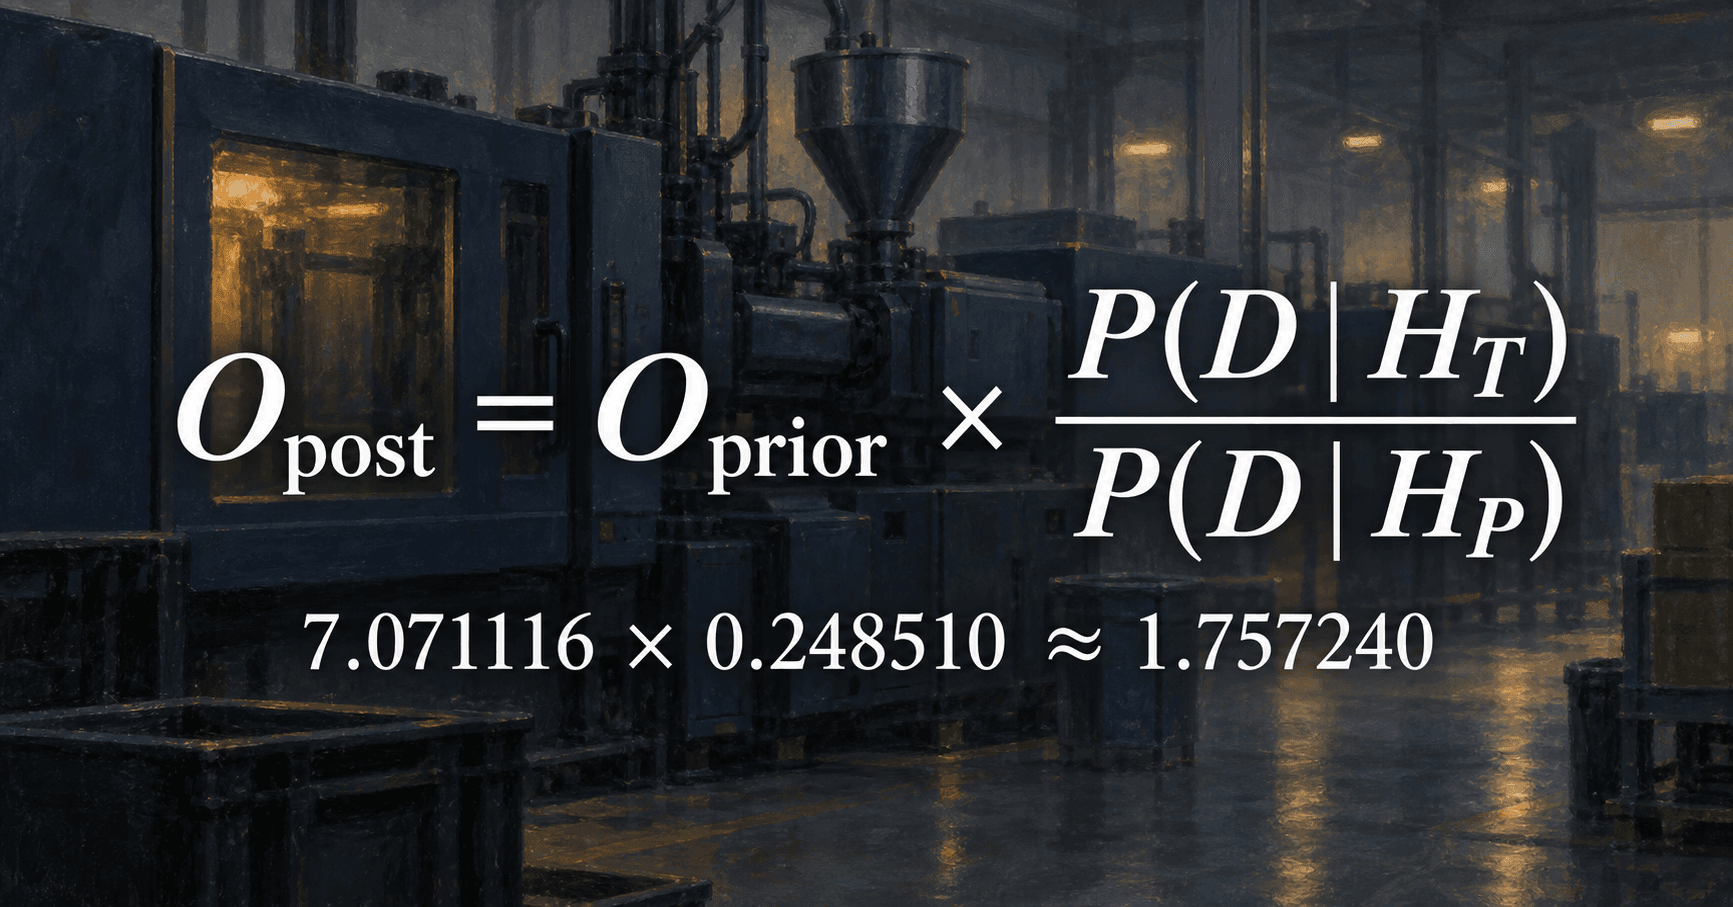
系列文章: 沉默工厂: 第2篇Theory & Methods
短射原因的概率:从贝叶斯定理到赔率与贝叶斯因子
通过贝叶斯定理和赔率验算温度与压力假设,解释上午87.6%、下午63.7%的序贯更新,并延伸到将交易和活动记录连接至判断与执行的系统化。
- Bayesian
- 贝叶斯定理
- 贝叶斯因子
Evidence, methods, and operating insight for decisions that must work in the field.
通过贝叶斯定理和赔率验算温度与压力假设,解释上午87.6%、下午63.7%的序贯更新,并延伸到将交易和活动记录连接至判断与执行的系统化。
3,240种参数组合中如何找到'最优'?Grid Search进行穷举扫描,Youden's J Index找到灵敏度与特异度的平衡点。用业务场景解读销售阶段权重(T)与信号灵敏度(k)由数据自主调校的数学原理——Auto-Tuner的第一大支柱。
如果Grid Search找到了'最高的山丘',那么MCMC集成采样器就是256名探险家达成共识——'确认这个高度正确'的过程。Emcee的仿射不变行走者、R̂收敛诊断、HDI 95%可信区间、5-Fold交叉验证与Signal Lift分析的数学原理,结合业务场景深入解读。
BA03.[准时物料入库: 附录 1] EXA 引擎的解剖:混合分布与观测偏差
BA02.[附录 2:贝叶斯证据] 沉默的悖论:信息熵与对数加权几何学
本文阐述了 [BA02 集] 中探讨的贝叶斯引擎的数学原理及其有效性。旨在不确定的商业环境中精确预测销售成功概率。核心内容涵盖了将量化过去经验的 Beta 分布与捕捉现场实时信号的二项分布相结合,从而推导出最佳决策指标的过程。特别是强调了利用无需复杂运算即可实现即时更新的共轭先验分布,从而极大化系统的实时性和运算效率。此外,该模型采用了每当数据发生时立即做出判断的递归估计方式,确保了针对现代商业优化的技术合理性。结果表明,本资料清晰地展示了精密的数学建模如何将模糊的直觉转化为可靠的基于数据的洞察。
之所以选择强化学习(Reinforcement Learning,RL)作为本博客的第一个主题,一方面是因为我个人对强化学习抱有浓厚兴趣:它以传统理论为基础,沿着不同于近年来迅猛发展并备受关注的深度学习和 LLM AI 智能体的轨迹,不断发展并持续影响着现实世界;另一方面,强化学习将被整合到 Exavion 的扩展型 ERP、AI 集成企业应用 Exa-Solution 中,这也是主要原因之一。
许多初次接触强化学习的学习者无法清楚理解马尔可夫决策过程(Markov Decision Process,MDP)与强化学习(Reinforcement Learning)之间在概念上的差异和关系,因此常常在学习初期面临入门障碍。为了减少这种困惑,有必要先梳理二者之间的关系。