
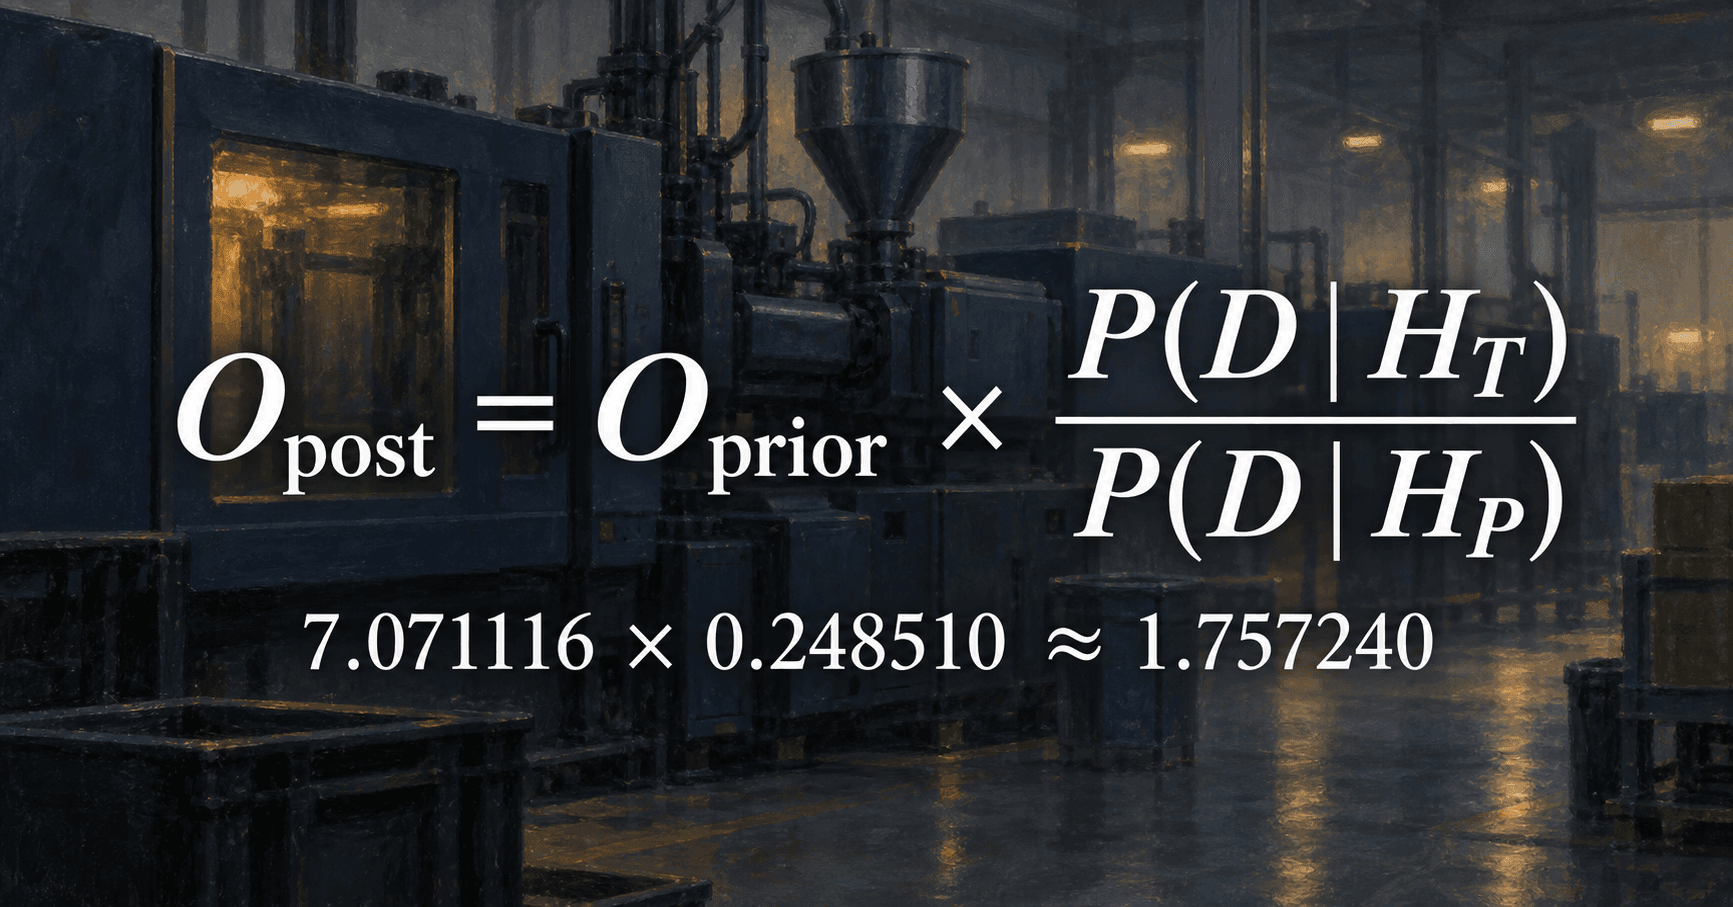
시리즈: 침묵의 공장: 2편Theory & Methods
쇼트샷의 원인 확률: 베이즈 정리에서 오즈와 베이즈 인자까지
온도와 압력의 쇼트샷 원인 가설을 베이즈 정리와 오즈로 검산한다. 오전 87.6%, 오후 63.7%의 순차 갱신을 설명하고 거래·활동 기록을 판단과 실행에 연결하는 시스템화로 이어진다.
- Bayesian
- 베이즈 정리
- 베이즈인자
Evidence, methods, and operating insight for decisions that must work in the field.
온도와 압력의 쇼트샷 원인 가설을 베이즈 정리와 오즈로 검산한다. 오전 87.6%, 오후 63.7%의 순차 갱신을 설명하고 거래·활동 기록을 판단과 실행에 연결하는 시스템화로 이어진다.
3,240개의 파라미터 조합 중 어떻게 '최적'을 찾는가? Grid Search가 전수 탐색하고, Youden's J 지수가 민감도와 특이도의 균형점을 찾는 수학적 원리를 비즈니스 맥락과 함께 풀어낸다. 영업 단계 가중치(T)와 시그널 민감도(k)를 데이터가 스스로 조율하는 Auto-Tuner의 첫 번째 기둥.
Grid Search가 '최적의 언덕'을 찾았다면, MCMC 앙상블 샘플러는 '그 언덕의 높이가 맞다'고 256명의 탐험가가 합의하는 과정이다. Emcee의 아핀 불변 워커, R̂ 수렴 진단, HDI 95% 신뢰구간, 그리고 5-Fold 교차검증과 Signal Lift 분석의 수학적 원리를 비즈니스 맥락과 함께 풀어낸다.
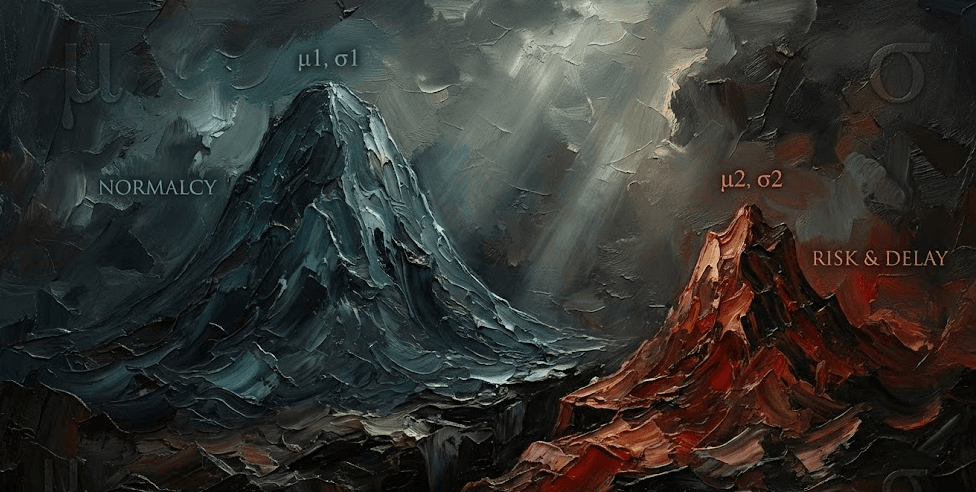
이 글은 소설 형식으로 연재된 [BA03 On-Time 자재입고: Bayesian MCMC]편에서 활약한 EXA 엔진의 작동 원리를 규명하는 기술 해설 시리즈의 첫 번째 글입니다. 이번 시리즈는 베이지안 추론 중에서도 고급 기법에 속하는 혼합분포(Mixture Distribution)와 MCMC(Markov Chain Monte Carlo) Gibbs Sampling을 다루는 만큼, 내용이 깊고 계산 과정이 다소 복잡할 수 있습니다. 따라서 이를 가능한 쉽게 소화할 수 있도록 단계별로 나누어 상세히 접근하고자 하며, 제법 긴 여정이 될 것으로 예상됩니다. 전체적인 맥락 이해를 위해 소설 원문을 먼저 일독을 권합니다. 아울러 베이지안 이론은 단계적으로 개념이 확장되므로, BA01 및 BA02의 에피소드와 수학 해설을 먼저 살펴본다면 이번 내용을 받아들이는 데 훨씬 도움이 될 것입니다. 앞선 수학적 개념과 논리들이 이어지고 있습니다.
이 글은 [BA02.베이지안 추론] 영업의 보이지 않는 손: 60일의 도박의 2번째 시리즈 글이다. 지난 [제1부 베이지안 엔진: 불확실성을 관리하는 수학적 연금술]에서는 컬레사전분포와 해석해의 우아함을 다뤘다면 제2부에서는 증거 데이터인 우도(likelihood)의 계산과 비즈니스 현장에서 가장 위협적인 유령, '침묵(Silence)'을 수학적으로 어떻게 처리하는를 검토한다.
이 아티클은[BA02 에피소드]에서 다뤘던 베이지안 엔진의 수학적 원리와 그 효과성을 설명한다. 불확실한 비즈니스 환경에서 영업 성공 확률을 정교하게 예측하기 위함이다. 핵심적으로 과거의 경험을 수치화하는 베타 분포와 현장의 실시간 신호를 포착하는 이항 분포를 결합하여 최적의 의사결정 지표를 도출하는 과정을 다룬다. 특히 복잡한 연산 없이도 즉각적인 업데이트가 가능한 켤레 사전 분포를 활용함으로써 시스템의 실시간성과 연산 효율성을 극대화하는 점을 강조한다. 또한, 이 모델은 데이터가 발생할 때마다 즉시 판단을 내리는 재귀적 추정 방식을 채택하여 현대 비즈니스에 최적화된 기술적 타당성을 확보한다. 결과적으로 본 자료는 정교한 수학적 모델링이 어떻게 막연한 직관을 신뢰할 수 있는 데이터 기반의 통찰로 변환시키는지를 명확하게 보여준다.
강화학습(Reinforecemnt Learning: RL)을 본 블로그의 첫 주제로 선택한 이유는 최근 급격히 발전하고 주목받는 딥러닝과 LLM AI 에이전트들과는 다른 궤도에서, 전통적인 이론을 바탕으로 현실세계에 지속적인 영향을 끼치며 발전해온 강화학습에 대한 개인적인 관심과 Exavion의 확장된 ERP, AI 통합 기업 어플리케이션 Exa-Solution에 강화학습이 통합되는 것 또한 주된 이유 중의 하나이다
강화학습을 처음 접하는 학습자들 가운데 상당수는 MDP(Markov Decision Process)와 강화학습(Reinforcement Learning) 간의 개념적 차이와 관계를 명확히 이해하지 못해 학습 초기 단계에서 진입장벽을 경험하곤 한다. 이러한 혼란을 줄이기 위해서는 두 개념의 관계를 먼저 정리해볼 필요가 있다.