
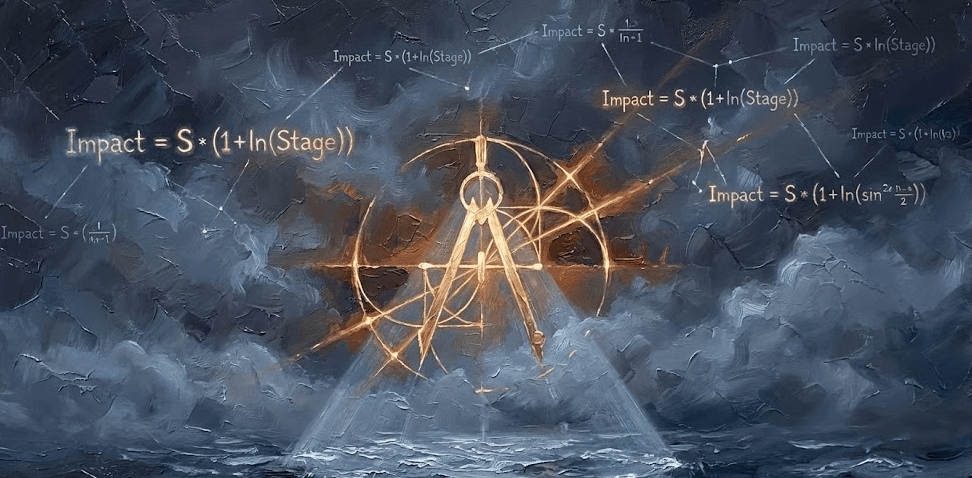
シリーズ: 60日間の賭け: 第3回Business Decision Science
沈黙の逆説:情報エントロピーと対数重み付けの幾何学
BA02.[付録 2:ベイズ証拠] 沈黙の逆説:情報エントロピーと対数重み付けの幾何学
- Bayesian
- Bayesian
- likelihood
Evidence, methods, and operating insight for decisions that must work in the field.
BA02.[付録 2:ベイズ証拠] 沈黙の逆説:情報エントロピーと対数重み付けの幾何学
この記事では、[BA02エピソード]で扱ったベイズエンジンの数学的原理とその効果について説明する。不確実なビジネス環境において、営業成功確率を精緻に予測するためである。核心として、過去の経験を数値化するベータ分布と、現場のリアルタイムなシグナルを捉える二項分布を結合し、最適の意思決定指標を導き出すプロセスを扱う。特に、複雑な演算なしで即時アップデートが可能な共役事前分布を活用することで、システムのリアルタイム性と演算効率を極大化する点を強調する。また、このモデルはデータが発生するたびに即座に判断を下す再帰的推定方式を採用し、現代のビジネスに最適化された技術的な妥当性を確保している。結果として、本資料は精緻な数学的モデリングがいかに曖昧な直感を信頼できるデータに基づいた洞察へと変換させるかを明確に示している。
営業現場の観察と顧客反応をベイズの証拠として更新し、60日間にわたり受注確率を追跡しながら、限られた営業資源をより有望な顧客と行動へ配分するExaWin+の意思決定事例です。
強化学習(Reinforcement Learning: RL)を本ブログの最初のテーマに選んだ理由は、近年急速に発展し注目を集めている深層学習やLLM AIエージェントとは異なる軌道を歩み、伝統的な理論を基盤として現実世界に継続的な影響を与えながら発展してきた強化学習への個人的な関心と、Exavionの拡張ERP、AI統合型企業アプリケーションであるExa-Solutionに強化学習が統合されることにある。
強化学習を初めて学ぶ人の多くは、MDP(Markov Decision Process)と強化学習(Reinforcement Learning)の概念的な違いと関係を明確に理解できず、学習の初期段階で壁にぶつかることがある。この混乱を減らすには、まず二つの概念の関係を整理する必要がある。