

Bài viết này là phần đầu tiên trong chuỗi giải thích kỹ thuật nhằm làm rõ nguyên lý hoạt động của động cơ EXA, vốn đóng vai trò quan trọng trong loạt bài viết dạng tiểu thuyết 'BA03 Vật tư về đúng hạn: Bayesian MCMC'.
Vì loạt bài này đề cập đến Phân phối hỗn hợp (Mixture Distribution) và MCMC (Markov Chain Monte Carlo) Gibbs Sampling — những kỹ thuật cao cấp trong suy luận Bayesian — nên nội dung có thể sâu sắc và quá trình tính toán có phần phức tạp. Do đó, chúng tôi dự định tiếp cận vấn đề này theo từng bước chi tiết để người đọc dễ tiếp nhận nhất có thể, và dự kiến đây sẽ là một hành trình khá dài.
Để hiểu rõ bối cảnh chung, chúng tôi khuyên bạn nên đọc nguyên tác tiểu thuyết trước. Ngoài ra, vì lý thuyết Bayesian mở rộng khái niệm theo từng giai đoạn, việc xem xét các tập phim và giải thích toán học của BA01 và BA02 trước sẽ giúp ích rất nhiều trong việc nắm bắt nội dung này. Các khái niệm và logic toán học trước đó đang được tiếp nối.
1. Định nghĩa dữ liệu: Sai lệch quan sát (Observation Deviation)
Để mô hình hóa về mặt toán học vấn đề cốt lõi được đề cập trong tiểu thuyết là 'Đúng hạn (On-Time)', trước hết chúng ta phải định nghĩa dữ liệu. Để làm được điều này, chúng ta tạo dữ liệu quan sát mẫu theo đơn vị ngày như sau.
Chúng ta có thể xem tập hợp các ngày chậm trễ quan sát được này là một Vector, và mỗi giá trị chậm trễ (-2, -1, 0 ...) bên trong nó trở thành một Phần tử (Element hoặc thành phần) cấu thành nên vector này.
Tại đây, mỗi phần tử dữ liệu cá nhân được định nghĩa như sau:
Ý nghĩa của công thức này rất trực quan:
: Trường hợp giữ đúng lời hứa (Đúng hạn - On-Time)
: Trường hợp bị chậm so với kế hoạch (Ví dụ: +5 là chậm 5 ngày)
: Trường hợp đến sớm hơn so với kế hoạch (Nhập hàng sớm)
Mô hình Ngày chậm trễ (Delay Days) này có thể được áp dụng để đo lường các nút thắt cổ chai (Bottleneck) khác nhau tại hiện trường kinh doanh:
Chậm trễ nhập vật tư và công việc của nhà cung cấp (Lead Time Delay)
Chậm trễ vận chuyển và logistics (Transportation Delay)
Chậm trễ quy trình của dây chuyền sản xuất (Production Delay)
Kích thước (số chiều) của dữ liệu vector được quyết định bởi quy mô kinh doanh. Nếu có 100 giao dịch quan sát được, nó sẽ là một vector gồm 100 phần tử; nếu có 300 giao dịch, nó sẽ là 300 phần tử.
Trong loạt bài này, để giải phẫu rõ ràng nguyên lý hoạt động của động cơ EXA, chúng ta sử dụng 7 'Dữ liệu đồ chơi (Toy Data)' đã định nghĩa trước đó làm ví dụ. Mặc dù hàng trăm, hàng nghìn dữ liệu là thực tế, nhưng chúng có giới hạn trong việc thể hiện trực quan các quá trình tính toán phức tạp.
Tất nhiên, khi áp dụng vào thực tế, dữ liệu phải được quản lý chi tiết (Granularity) theo mục đích ra quyết định như "Nhà cung cấp + Mặt hàng + Phương thức vận chuyển + Điểm đến" hoặc "Dây chuyền + Sản phẩm" của sản xuất, từ đó có thể nắm bắt chính xác rủi ro trên toàn bộ SCM.
2. Trực quan hóa dữ liệu: Hai đỉnh núi
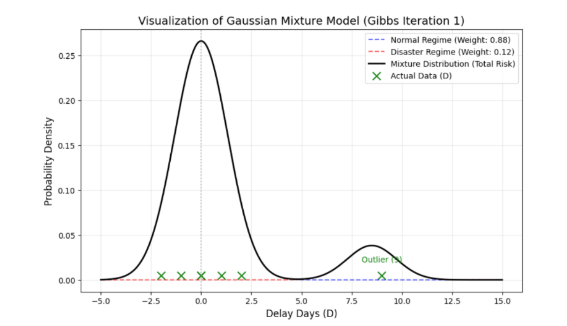
Bây giờ, hãy trực quan hóa dữ liệu đồ chơi (Vector ) của chúng ta. Hãy kiểm tra xem 7 phần tử được sắp xếp như thế nào trên biểu đồ.
Dữ liệu thực tế thì sao? Dưới đây là biểu đồ tần suất (histogram) thể hiện 200 giao dịch mua vật tư thực tế (một mặt hàng cụ thể từ một nhà cung cấp cụ thể) của một doanh nghiệp.
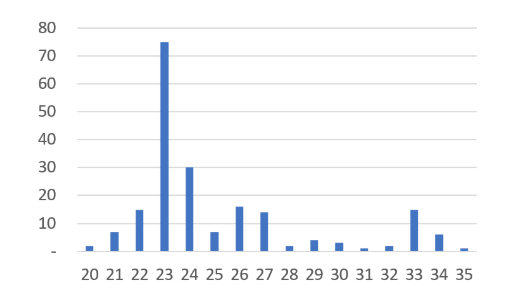
Một sự tương đồng thú vị được phát hiện. Dữ liệu đồ chơi của chúng ta phân tán xung quanh trạng thái bình thường (0), đồng thời hình thành một đỉnh núi riêng biệt là trạng thái chậm trễ (9). Dữ liệu doanh nghiệp thực tế cũng được chia thành một đỉnh núi tập trung quanh thời gian chờ (lead time) bình thường trung bình 23 ngày và một đỉnh núi khác, tuy yếu hơn, tập trung quanh trạng thái chậm trễ 33 ngày.
Hầu hết dữ liệu về ngày chậm trễ đều có dạng hai đỉnh núi như thế này. Trong dữ liệu thực tế, đôi khi có thể xuất hiện từ 3 đỉnh núi trở lên. Tuy nhiên, thay vì mô hình hóa từng đỉnh núi riêng lẻ, chúng tôi nén nó thành mô hình 2-chế độ (Bình thường/Chậm trễ) để phù hợp với cấu trúc nơi các quyết định thực sự được thực hiện (Vận hành bình thường vs Đối ứng bất thường).
Đây không đơn thuần là việc thu nhỏ thực tế. Đó là khía cạnh của Thiết kế vận hành (Operational Design) nhằm giảm thiểu sự không chắc chắn, ổn định phán đoán và làm cho việc thực thi trở nên nhất quán. Các mô hình chi tiết (như chậm trễ nhẹ) có thể được mở rộng khi cần thiết, nhưng động cơ cơ bản sẽ bền vững nhất khi được định nghĩa bởi hai trạng thái (Regime): 'Bình thường' và 'Chậm trễ'.
3. Giả định thống kê: Tính hợp lý của phân phối chuẩn
Tại đây, chúng ta thiết lập một giả định thống kê quan trọng: "Dữ liệu ngày chậm trễ tuân theo Phân phối chuẩn (Normal Distribution) phân tán hình chuông quanh giá trị trung bình."
Tại sao lại là phân phối chuẩn?
Có người sẽ hỏi: "Liệu thực tế có thực sự tuân theo phân phối chuẩn như trong sách giáo khoa không?". Tuy nhiên, theo Định lý giới hạn trung tâm (Central Limit Theorem) của thống kê, giá trị kết quả được tạo ra bởi sự kết hợp của nhiều biến số độc lập (tình trạng của công nhân, thời tiết, tình hình giao thông, lỗi cơ khí nhỏ, v.v.) sẽ hội tụ về phân phối chuẩn nếu kích thước mẫu đủ lớn. Nói cách khác, việc mô hình hóa sự không chắc chắn của quy trình và logistics bằng phân phối chuẩn là cách tiếp cận hợp lý và có giá trị về mặt toán học nhất.
4. Kết luận và các bước tiếp theo
Cuối cùng, biểu đồ mà chúng ta đang thấy là sự kết hợp của 'Phân phối chuẩn trạng thái bình thường' và 'Phân phối chuẩn trạng thái chậm trễ'. Đây chính là thực thể của Phân phối hỗn hợp (Mixture Distribution) mà động cơ EXA trong tiểu thuyết muốn giải thích.
[Kết luận phần 1] Dữ liệu chúng ta quan sát được, tức là hàm Khả năng (Likelihood), là một phân phối hỗn hợp được cấu thành từ hai phân phối chuẩn riêng lẻ.
Mục tiêu hàng đầu là tìm ra Rủi ro đúng hạn (On-Time Risk), tức là xác suất có thể xảy ra chậm trễ, từ dữ liệu quan sát cấu thành từ các phân phối hỗn hợp này bằng suy luận Bayesian.
Để làm được điều này, trong bài viết tiếp theo [Phụ lục 2], chúng tôi sẽ thiết kế một mô hình toán học cụ thể để giải quyết hàm khả năng cấu thành từ phân phối hỗn hợp bằng phương pháp Bayesian.

Tham gia thảo luận